
上市公司劳动节约型创新【00-2025】|含原始专利、标注数据、Python与Stata代码
数据简介
参考皮淑雯等(2026)的研究思路,本数据集基于专利文本语义构建企业劳动节约型创新指标,用于衡量上市公司通过自动化、智能化装备与系统替代人工操作、减少人工参与或缩短劳动工时的技术创新水平。与只检索“自动化”“机器人”“节约人工”等固定关键词的方法相比,文本语义模型能够识别未直接出现上述关键词、但实际承担人工控制、检测、分拣、装配、搬运、录入、巡检或值守任务的技术方案,从而更完整地捕捉企业的劳动替代型技术创新。原始专利信息来源于国家知识产权局网站公开的专利数据,正式测算范围为2000—2025年,数据以专利申请年度为时间口径,并按照“股票代码—专利申请号”进行去重。正式测算共纳入620万+项创新专利,其中摘要有效专利6203138项。
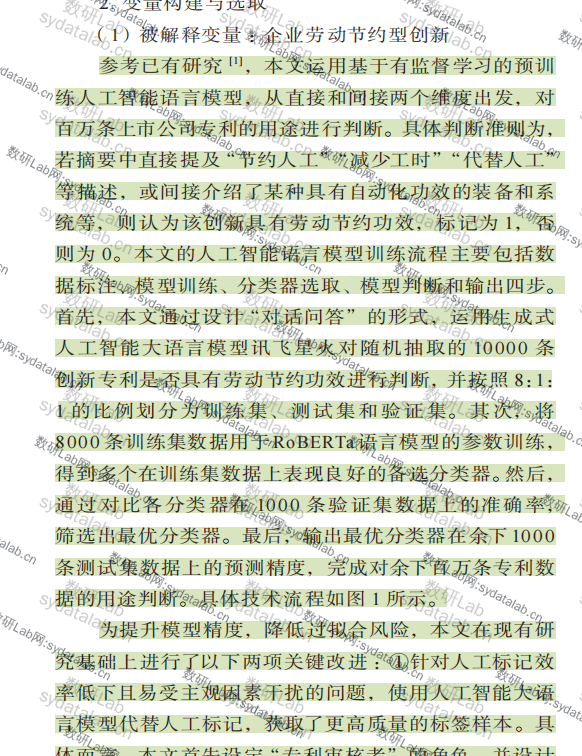
具体测算过程如下所示:
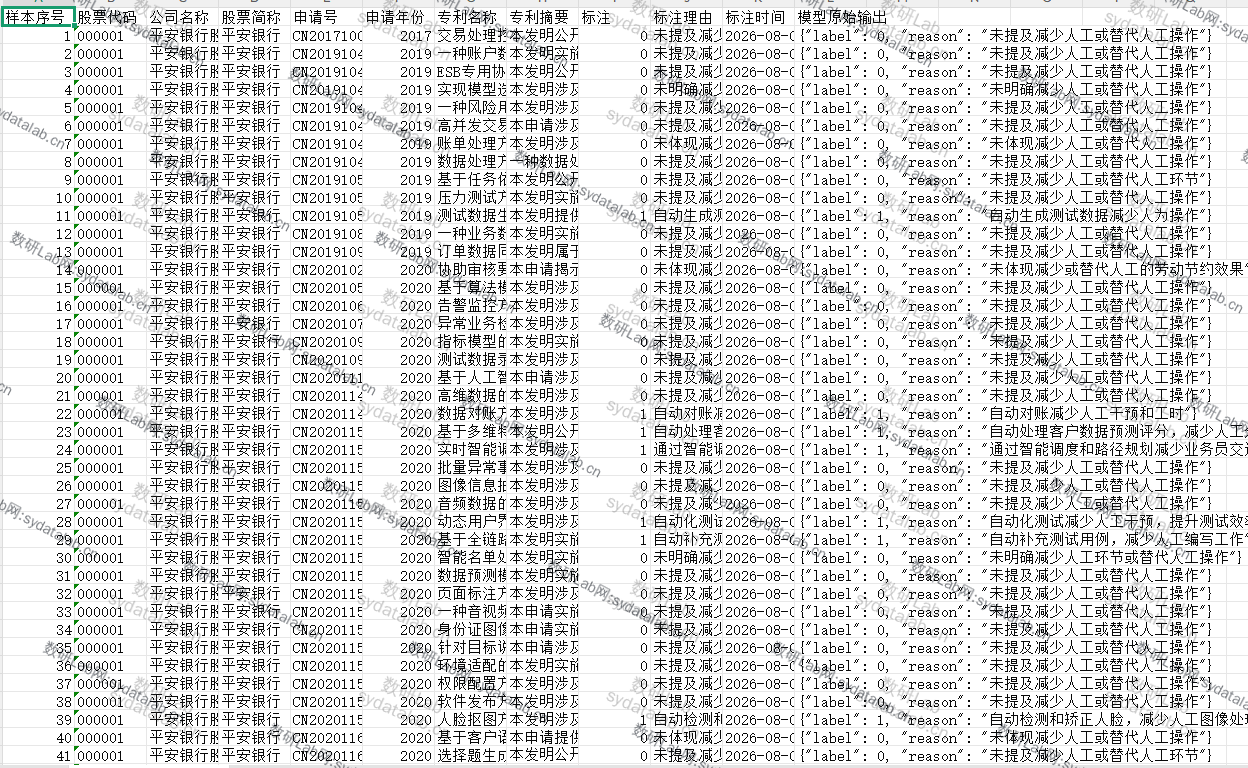
(1)从摘要长度达到基本语义识别要求的专利中,随机抽取10%作为生成式模型标注样本,共得到620660条企业—专利标注记录。使用Qwen3生成式模型按照统一规则进行零温度确定性标注:若专利直接说明节约人工、减少工时、降低人力投入或替代人工,或者技术方案实际执行了原本需要人工完成的控制、检测、分拣、装配、搬运、录入、巡检和无人值守等任务,则标记为劳动节约型专利;如果专利仅笼统说明提高效率、精度、便利性、可靠性、节能或降低一般成本,但没有体现减少或替代人工,则标记为非劳动节约型专利。信息不足时从严判定为非劳动节约型。
(2)按照专利申请号对标注数据去重,得到619,271项有效训练样本,其中劳动节约型正类81,773项,占13.20%。随后按照8∶1∶1的比例划分训练集、验证集和测试集,基于中文RoBERTa-wwm-ext预训练模型微调劳动节约型专利二分类器。模型验证集准确率为95.32%、精确率为83.47%、召回率为80.51%、F1值为81.96%;测试集准确率为95.41%、精确率为83.89%、召回率为80.79%、F1值为82.31%。
(3)利用训练完成的RoBERTa模型对全部有效专利摘要进行批量预测,以0.5作为分类阈值,得到专利级劳动节约型标记和劳动节约概率。摘要缺失或长度不足的专利不进行语义预测,其劳动节约型标记和预测概率保留为空。全量识别最终得到劳动节约型专利795,937项,占有效摘要专利的12.83%。
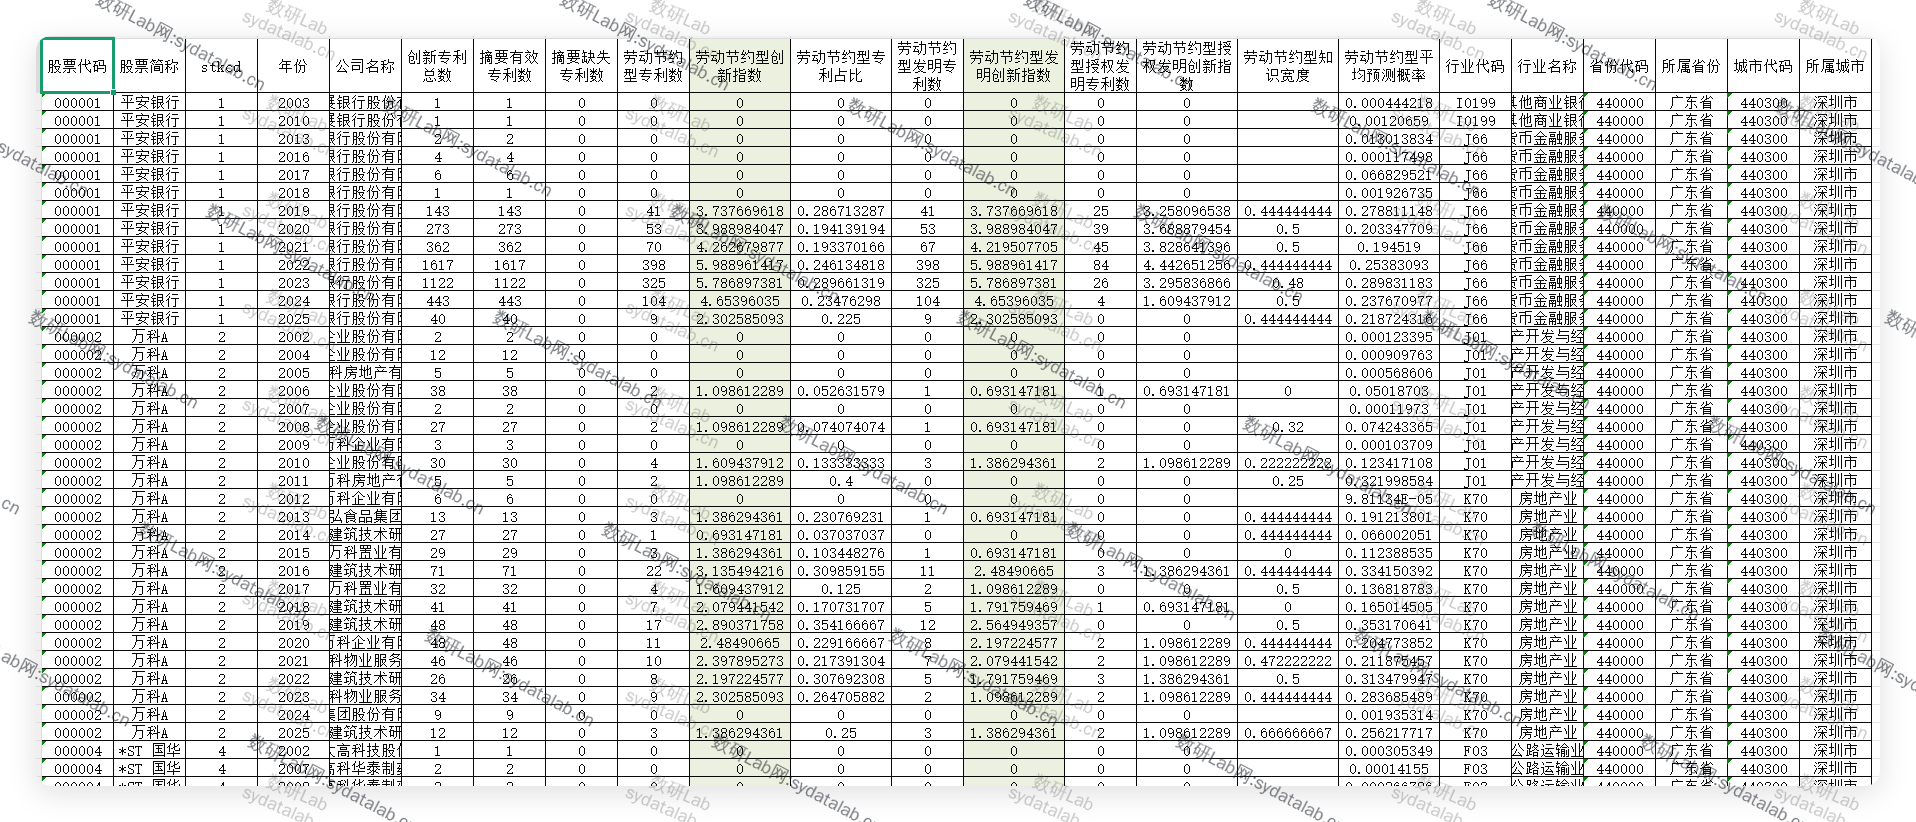
(4)按照股票代码和专利申请年度汇总专利级预测结果。企业劳动节约型创新的核心指标计算公式为:
Labsav_innov_it=ln(1+N_it)
其中,N_it表示企业i在t年度申请的劳动节约型专利数量;Labsav_innov_it为企业年度劳动节约型创新指数。指标采用专利数量加1后取自然对数的方式处理。指标值越大,说明企业当年通过自动化、智能化技术替代或减少人工劳动的创新活动越多。
数据示例
参考文献
[1]皮淑雯,丁凤塔,孟佶贤,等.员工流失风险感知与企业劳动节约型创新[J].南开管理评论, 2026(4).