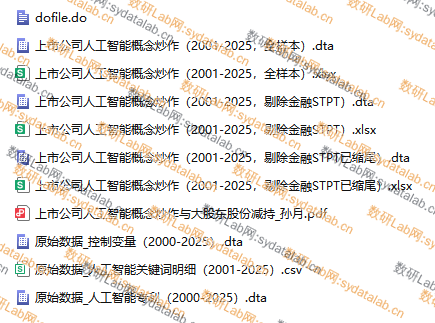
上市公司人工智能概念炒作(2001-2025)
数据简介
本数据参考孙月等(2025)关于上市公司人工智能概念炒作的研究思路,利用我国A股上市公司年度报告文本、人工智能专利数据和企业财务治理数据,构建2001—2025年上市公司人工智能概念炒作指标。
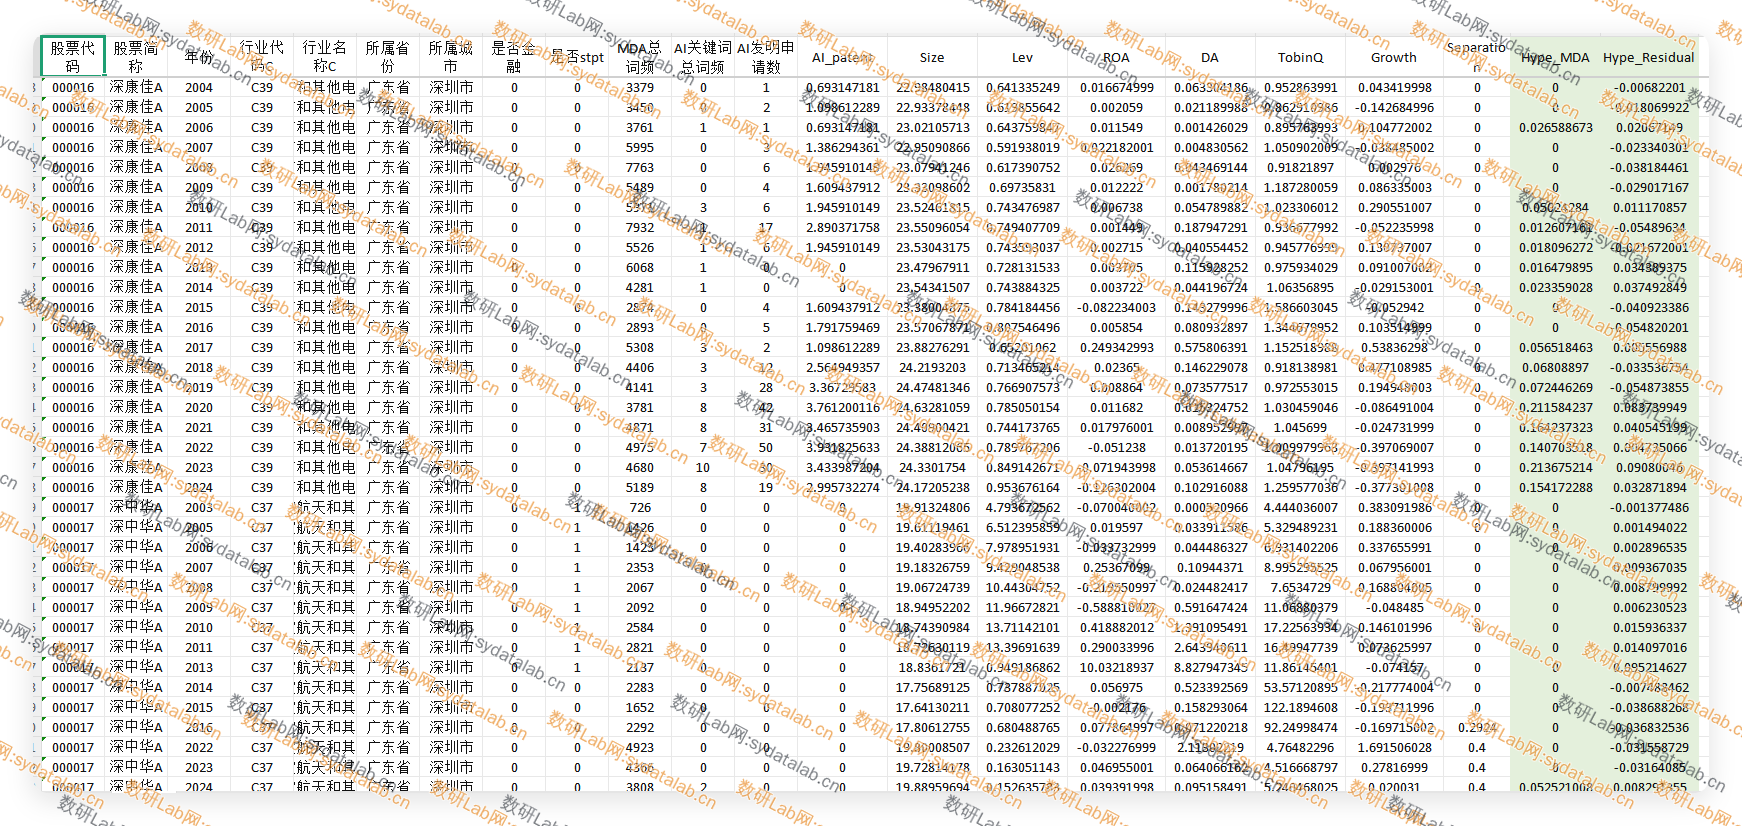
人工智能文本披露指标根据孙月等(2025)所使用的人工智能词典进行计算。首先,对上市公司年度报告中的MD&A文本进行清洗和分词,统计人工智能、机器学习、深度学习、自然语言处理、计算机视觉、区块链、云计算、物联网等55个关键词或技术术语的出现次数,汇总得到“AI关键词总词频”。为消除不同企业年报篇幅差异的影响,使用“AI关键词总词频÷MD&A总词频×100”计算人工智能披露强度,并将其记为 Hype_MDA。该指标越大,说明企业在MD&A中对人工智能相关概念的讨论越集中,但它既可能反映企业真实的人工智能技术投入,也可能包含超出企业实际技术能力的策略性披露,因此还需要结合专利和公司基本面进行进一步识别。
在异常人工智能披露的测算中,使用企业人工智能发明专利申请数量衡量其真实人工智能创新能力,并进行 ln(1+AI发明申请数) 处理。原始专利数据来源于国家知识产权局数据库,随后,以 Hype_MDA 为被解释变量,将人工智能专利、企业规模、资产负债率、总资产收益率、操纵性应计利润、托宾Q、营业收入增长率和两权分离度作为解释变量,同时控制企业固定效应和年份固定效应。模型残差记为 Hype_Residual,用于衡量在控制企业真实人工智能创新能力、经营特征及不可观测个体差异之后,企业超出正常水平的人工智能文本披露。Hype_Residual 越大,说明企业人工智能披露程度相对于其专利和基本面水平越高,可视为人工智能概念炒作程度较强;残差较小或为负,则表示人工智能披露与企业实际技术和经营条件相对匹配,或者披露程度低于模型预测水平。
数据示例