
上市公司-数字技术风险暴露(2000-2025)
数据简介
本数据参考陆瑶等(2025)文章,以A股上市公司年报中的管理层讨论与分析(MDA)文本为基础,采用“文献关键词筛选候选句—大模型抽样标注—FinBERT模型训练—全量候选句模型标注—企业年份层面变量聚合”的流程进行测算。样本期间为2001—2025年,最终覆盖71173个企业—年份观测值。
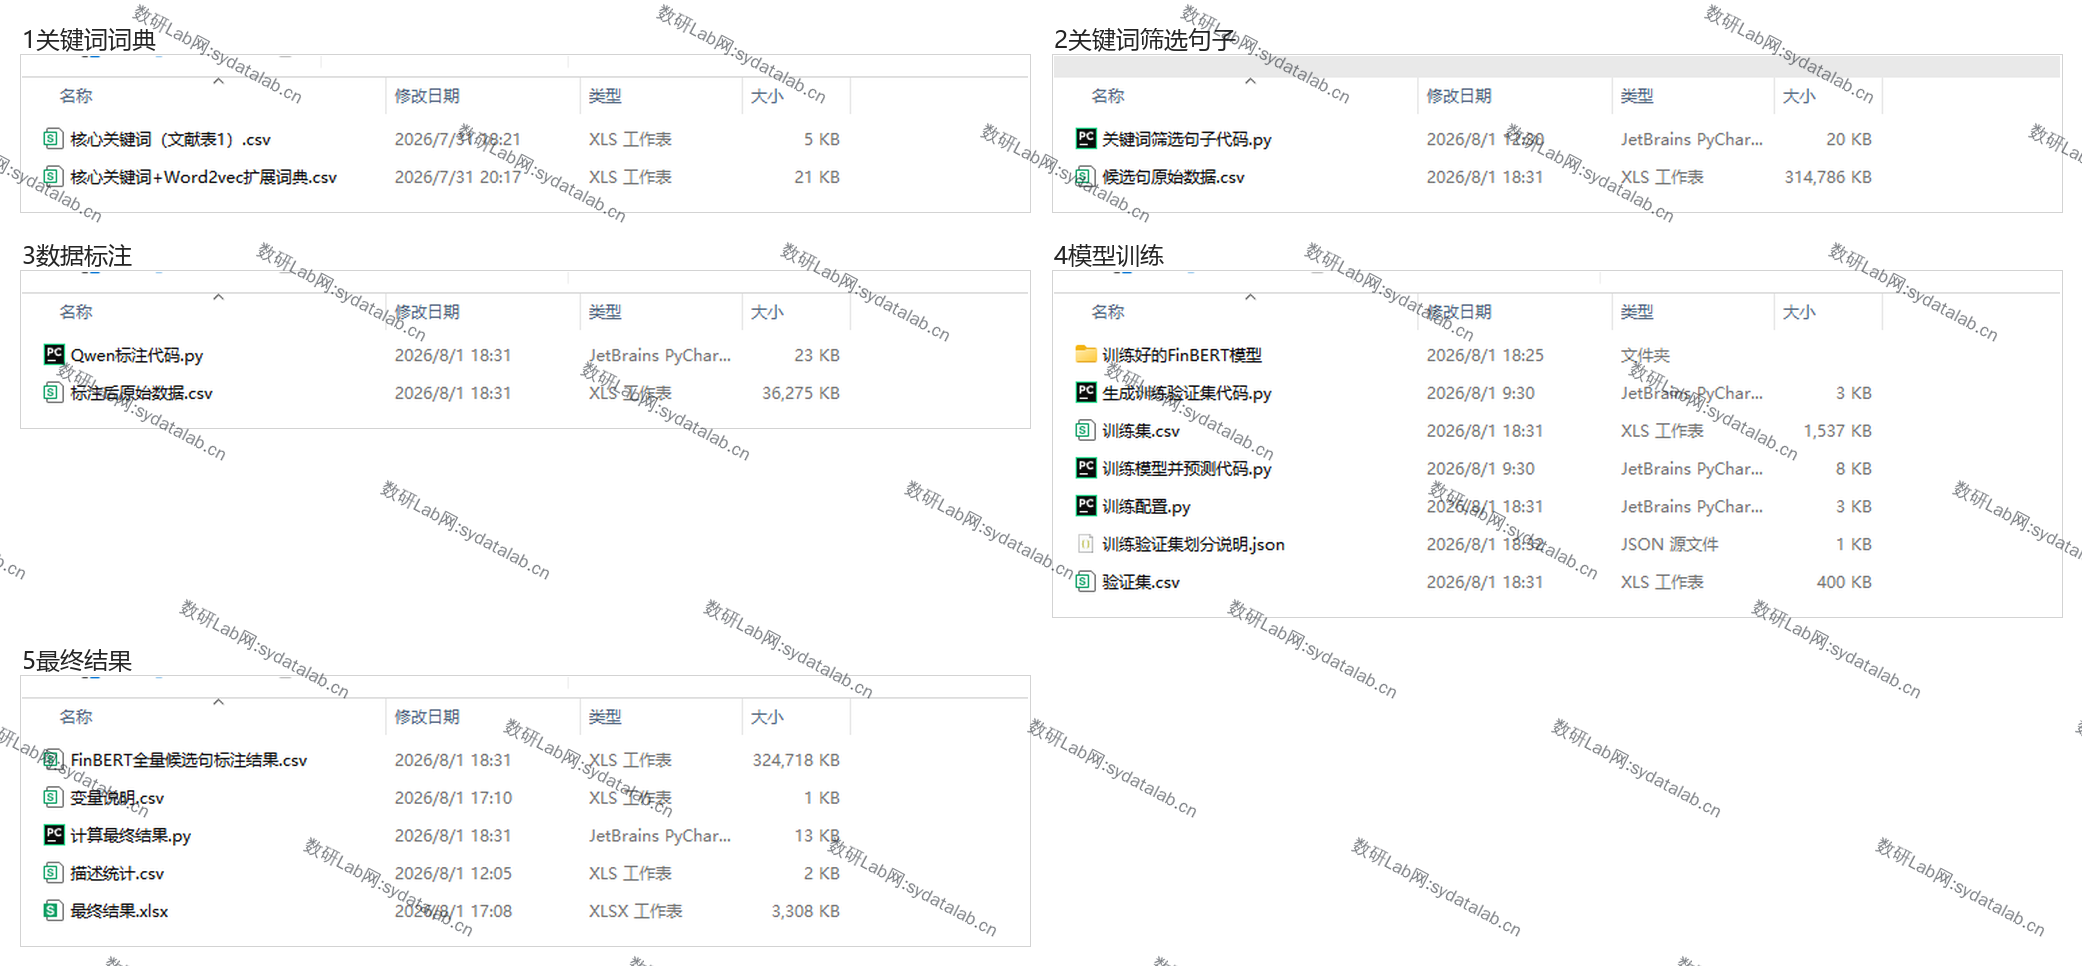
(1)构建数字技术风险候选句筛选词典。词典以陆瑶等文献表1中列示的数字技术风险关键词及类别为核心,覆盖数据风险、网络风险和具体技术风险三个维度,结合本地MDA文本语料使用Word2vec方法扩展相关词,并对扩展词进行人工筛选和去泛词处理。最终候选句筛选规则共包含236条关键词规则,其中表1原始关键词规则104条,Word2vec扩展关键词规则132条。
(2)对MDA文本进行分句和候选句筛选。将MDA文本切分为句子,并使用文献表1关键词和Word2vec扩展词进行匹配。凡是命中数字技术风险关键词、或满足关键词分词组合匹配规则的句子,均被纳入候选句库。经处理,分句得到15577832条句子,最终筛选得到226066条数字技术风险候选句。
(3)参考文献做法,从候选句中抽取10%左右比例样本,调用Qwen3模型进行句子级标注,标注时将候选句区分为风险暴露和风险防范。其中,风险暴露文本主要指企业披露数字技术相关风险、损失、威胁、故障、攻击、泄露等负面风险信息;风险防范文本主要指企业披露数字技术安全建设、风险管理、系统防护、数据保护、应急处置等正面防范信息。抽取样本中风险暴露11774条、风险防范10833条,并按80%和20%划分为训练集18085条、验证集4522条。
(4)在模型训练阶段,使用中文金融语境下的FinBERT作为基础模型,以二分类标注得到的风险暴露和风险防范句子作为训练样本进行微调。验证集accuracy为0.8224,macro F1为0.8224。随后使用训练好的FinBERT对226066条基础有效候选句进行全量标注,模型预测为风险暴露106540条、风险防范119526条;经0.50概率阈值和后续口径筛选,进入核心变量计算的风险暴露句75555条、风险防范句108370条。
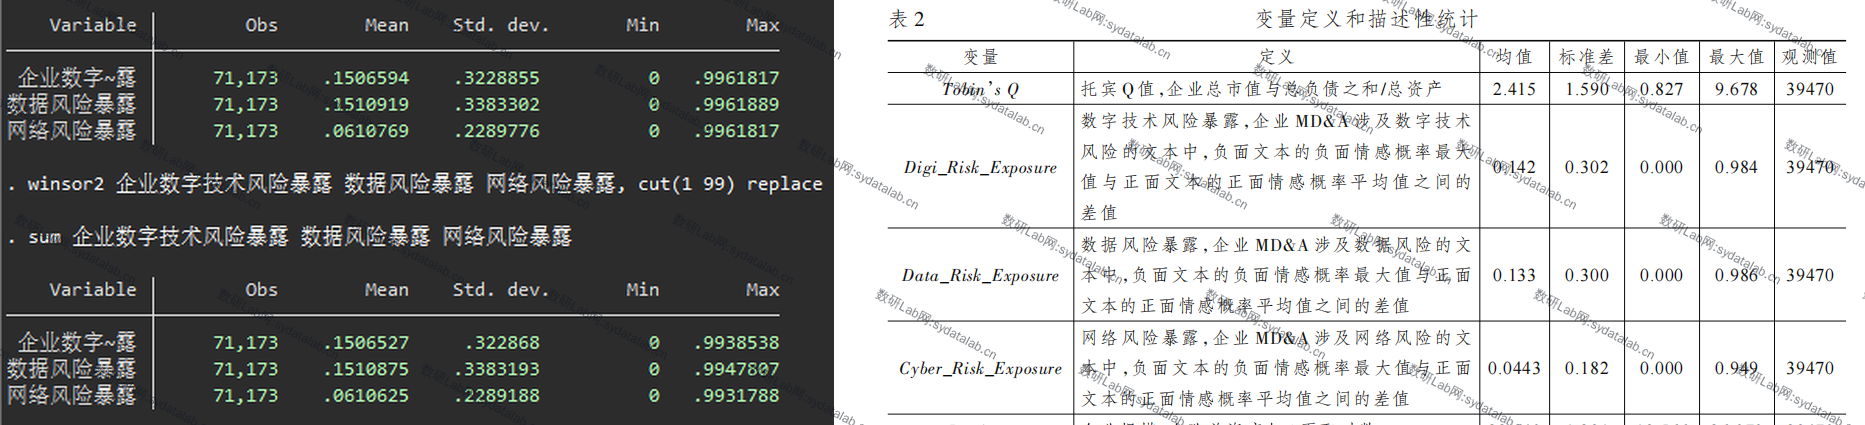
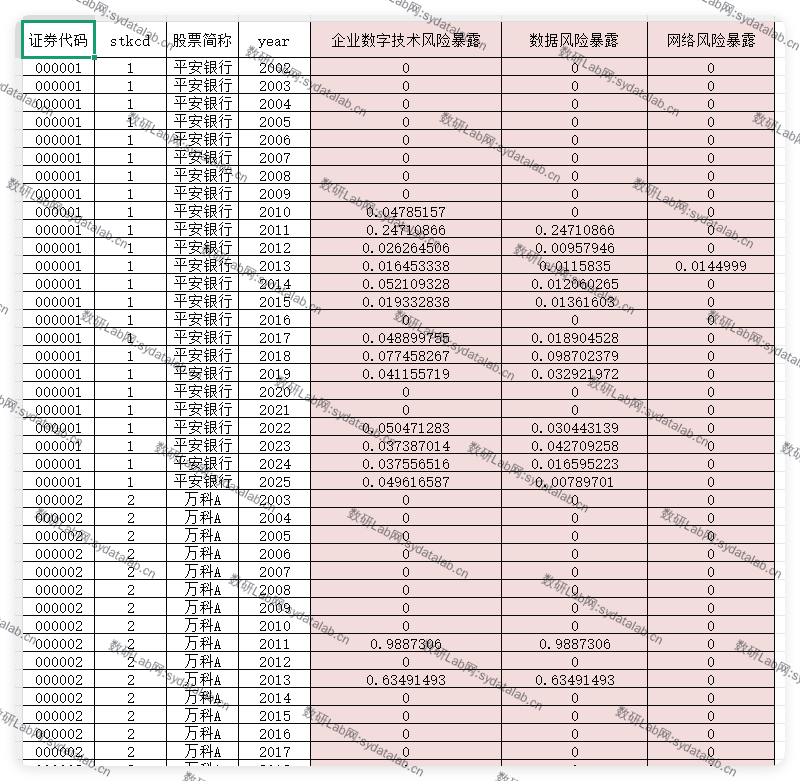
(5)在企业年份层面对FinBERT全量标注结果进行聚合。对每个股票代码和年份,先在全部数字技术风险候选句范围内计算企业数字技术风险暴露,再分别在数据风险、网络风险和具体技术风险候选句范围内计算三个子指标。具体公式为:max(风险暴露文本概率最大值 - 风险防范文本概率平均值, 0)。其中,风险暴露文本概率最大值反映企业该年度披露的最强数字技术风险暴露信号,风险防范文本概率平均值反映企业该年度披露的数字技术风险防范能力或管理措施,二者差值用于刻画净风险暴露程度;若差值小于0,则取0。最终输出2001—2025年A股上市公司企业数字技术风险暴露、数据风险暴露、网络风险暴露和具体技术风险暴露四个核心变量,最终结果包含71173个企业—年份观测值。
数据示例
参考文献
[1]陆瑶,施函青,周欣怡.中国企业数字技术风险暴露对企业价值的影响——来自大语言模型的文本分析证据[J].经济研究,2025,60(2):73-89.