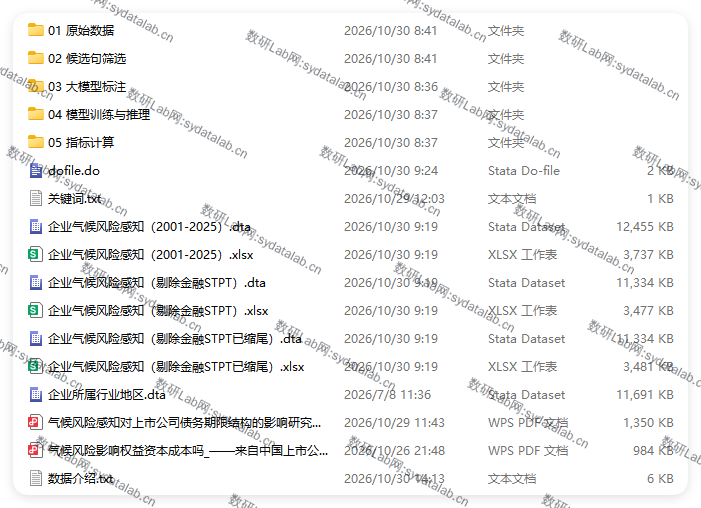
【大语言模型测算】上市公司气候风险感知(2001-2025)
数据简介
本数据基于中国A股上市公司年度报告MD&A(管理层讨论与分析)文本,刻画企业对物理气候风险与低碳转型风险的感知程度,重点识别企业在年报中披露的气候风险暴露信号及相应防范措施,并在企业—年度层面构建气候风险感知指标。与以碳排放量、ESG评级、气候灾害直接经济损失等量化结果衡量气候风险的数据不同,本数据从企业主动披露的文本信号出发,区分"风险暴露"与"风险防范"两类异质信息,并通过大语言模型标注与FinBERT微调模型提取句子层面的分类概率,进而汇总为企业年度感知指标,能够更细粒度地反映企业对气候风险的认知与应对状态。
关键词词典参考杜剑等(2023)《气候风险影响权益资本成本吗——来自中国上市公司年报文本分析的经验证据》的气候风险关键词设计,企业气候风险感知指标的测算方法(基于风险与防范分类概率差值的MCAI构建)参考严珂等(2026)《气候风险感知对上市公司债务期限结构的影响研究——基于大语言模型的经验证据》。具体测算过程如下:
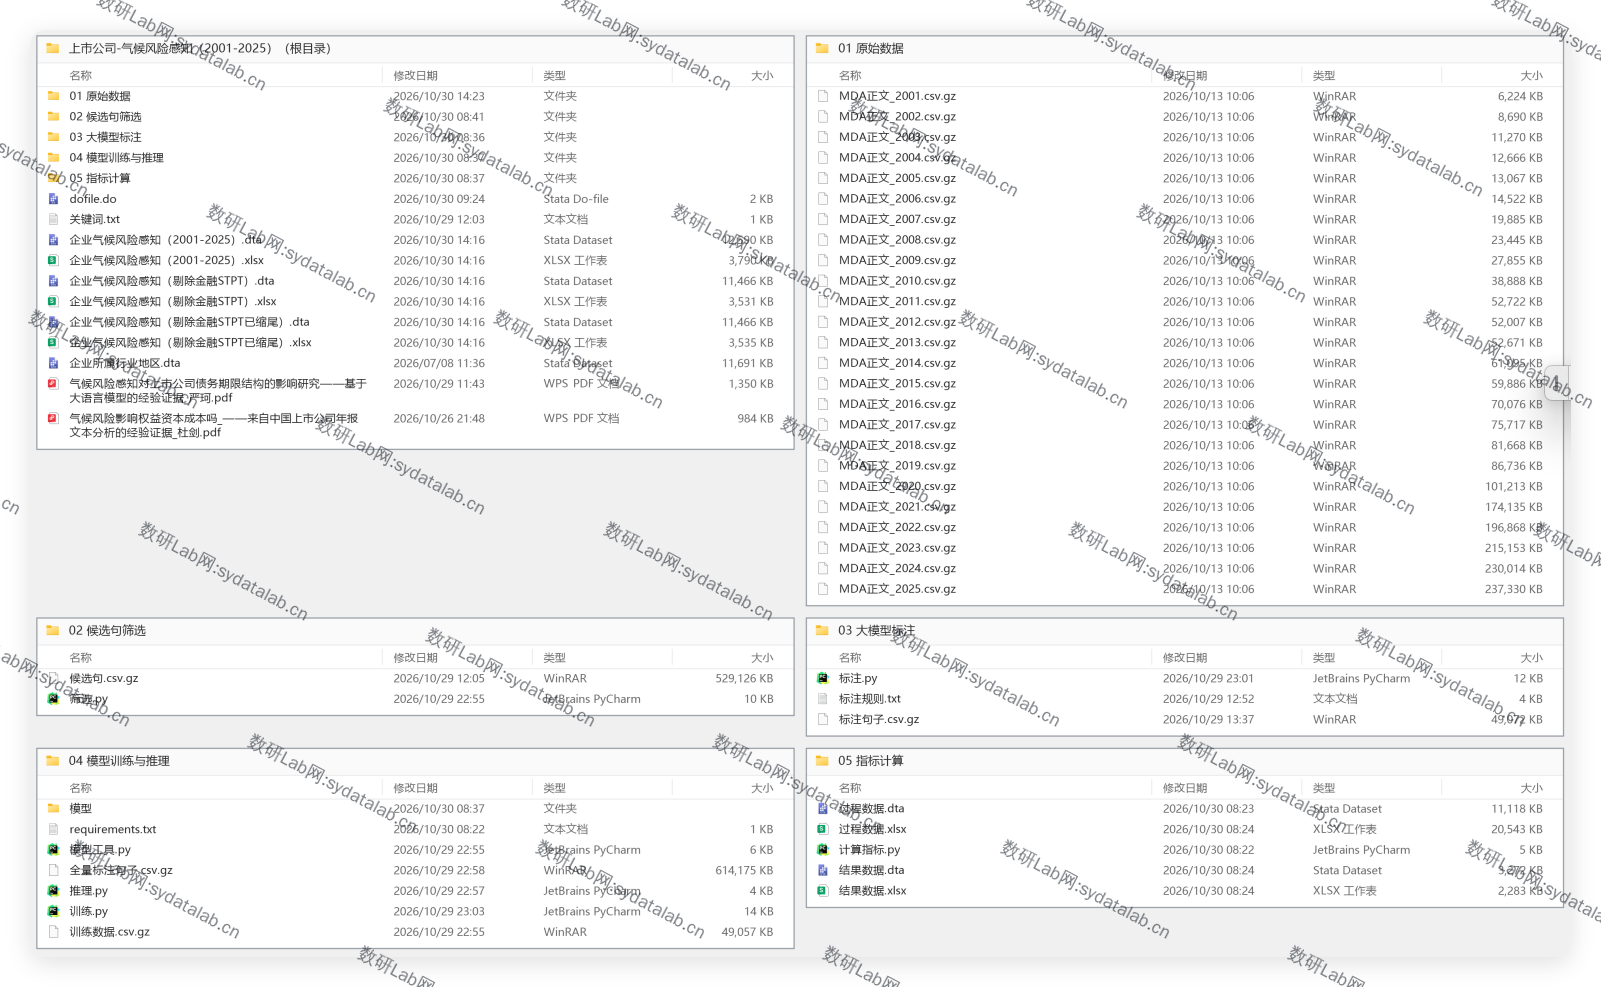
第一,基于关键词检索与邻句扩展构建候选文本。首先建立包含96个关键词的检索词典,覆盖两类语义:一是低碳转型与能源环保类表达(如低碳、绿色、减排、光伏、风电、清洁、生态、转型、能耗、增效等),二是物理气候灾害与天气水文类表达(如台风、洪涝、暴雨、干旱、寒潮、极端、灾害、汛期、气温、降水、海啸、泥石流等)。将命中有效关键词的句子纳入候选集合,并对命中气候锚定词的句子进行同段落前后句扩展,以保留通过指代、承接等方式描述的企业气候活动、潜在风险及防范措施。文本预处理统一规范字符形式、英文大小写及词语边界,对具有歧义的词汇设置语义限制,减少非气候内容的误识别。经过筛选,共获得约241万个候选句。
第二,结合DeepSeek-V4.1-Flash辅助标注与FinBERT微调模型开展文本识别。从候选句中抽取约10%(约22万余句)的样本,利用DeepSeek-V4.1-Flash大语言模型按照统一标注规则进行分类。标注规则区分物理风险(极端高温、强降雨、台风、洪涝、干旱、寒潮、海平面变化等对企业经营、资产、供应链和财务的实际或潜在影响)与转型风险(碳达峰、碳中和、碳市场、温室气体排放约束及低碳转型引起的政策法规、技术替代、市场及声誉风险),并对每句给出标签:风险暴露(-1)、防范措施(1)、无关或不足以判断(0)、混合(2);同时标注风险类型(物理、转型或兼具)。一般环保、污染防治、绿色景观、产业升级、宏观经营环境、节能降本和能源行业介绍,若没有明确的气候或低碳转型联系,不因命中"环境、能源、绿色、升级"等词即判为相关。
将上述机器标注结果作为监督训练数据,对中文FinBERT(FinBERT2-base)预训练模型进行三分类(无关、风险暴露、防范措施)微调,训练时排除混合标签,并依据验证集宏平均F1值选取最优检查点。在留出的32066条短文本测试样本中,模型分类准确率为97.82%,宏平均F1值为0.8023。完成模型微调后,将其应用于全量候选句集合,输出每个句子“无关概率、风险暴露概率、防范措施概率”三类分类概率,并按最大概率确定句子类别,形成企业气候风险与风险防范的句子级识别结果。
第三,基于风险与防范分类概率构建企业年度气候风险感知指标。参考严珂《气候风险感知对上市公司债务期限结构的影响研究——基于大语言模型的经验证据》的概率差值方法,将企业气候风险感知指标MCAI定义为企业当年最大风险概率与平均防范概率之差,即:
MCAI = 最大风险概率 − 平均防范概率
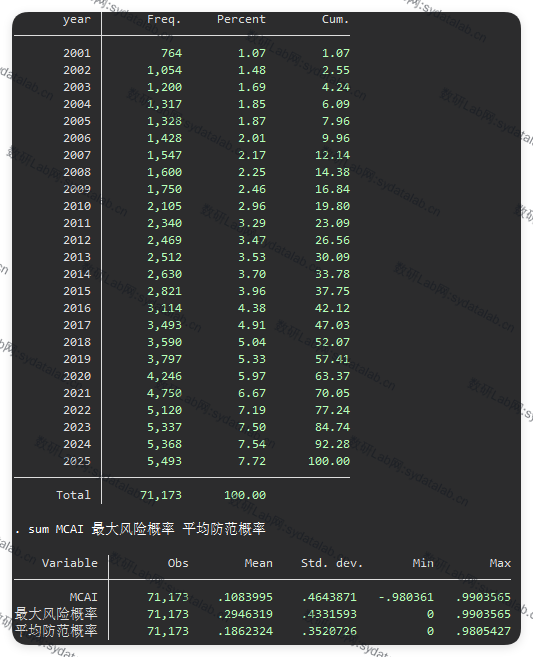
其中,最大风险概率为企业当年所有被识别为风险暴露句的风险分类概率最大值,用于反映年度报告中最强的风险披露信号;平均防范概率为企业当年所有被识别为防范措施句的防范分类概率算术平均值,用于衡量相关防范措施的文本披露信号。同一句同时涉及风险与防范时,分别纳入对应集合计算。对于未识别出风险句或防范句的企业年度,相应分项概率赋值为0;指标保留正负值,负值表示企业当年防范信号的强度超过风险信号。对于具有有效年报正文但未筛选出候选句的企业年度,相应概率赋值为0。根据上述识别与汇总方法,最终覆盖2001-2025年中国A股上市公司共6060家公司、7万+个公司—年度观测。相较于单纯依靠关键词频次或风险句数量的测算方式,本数据结合企业实际披露的气候风险与防范内容,利用FinBERT微调模型提取句子层面的分类概率,并进一步构建企业年度感知指标,以更有针对性地刻画上市公司对气候风险的认知与应对状态。
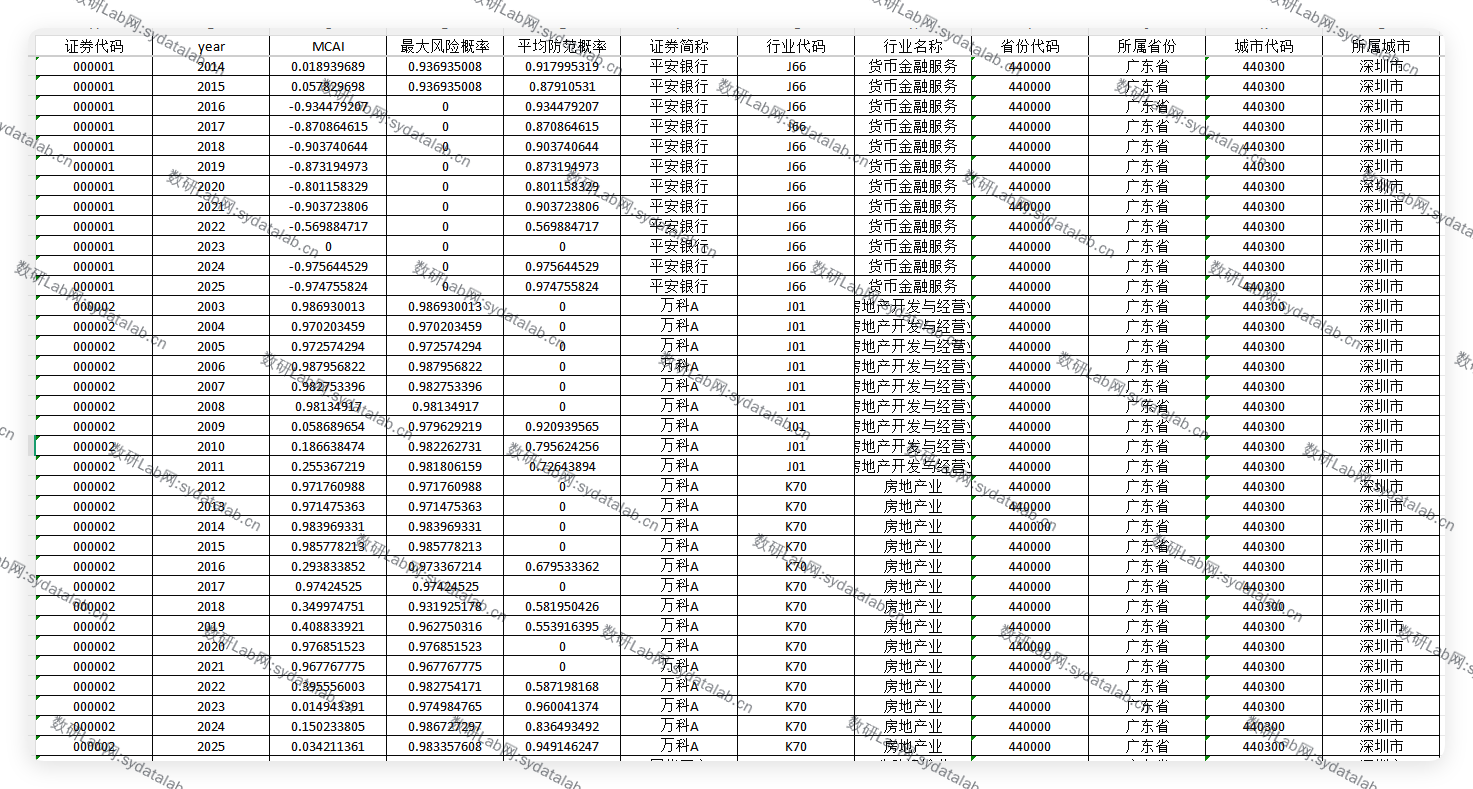
数据示例