
上市公司-人工智能暴露度、AI暴露度(2014-2025)
数据简介
人工智能暴露度数据参考刘行、张昊天和田轩(2025)《人工智能、人力资本结构与灵活用工—来自在线招聘大数据的经验证据》,结合国家知识产权局(CNIPA)中国专利数据库、上市公司网络招聘数据、机器之心人工智能术语库以及《中华人民共和国职业分类大典(2022年版)》进行测算。指标反映企业招聘岗位所承担的工作任务受到人工智能技术影响的程度。
一、主要数据来源
①人工智能术语来自机器之心开源的Artificial Intelligence Terminology Database v3.1,共收录2442条术语。程序同时整理英文术语、中文译名和常见缩写,生成用于专利标题和摘要检索的关键词表。
②职业信息来自《中华人民共和国职业分类大典(2022年版)》,共整理1636个标准职业细类及其职业定义和主要工作任务。职业任务进一步拆分为标准化的“动词-名词”组合,例如“分析-数据”“开发-算法”“检测-设备”等。与仅依据职业名称判断技术影响相比,任务层面的匹配能够更细致地识别同一职业内部不同工作内容受到人工智能影响的程度。
③专利数据来自国家知识产权局(CNIPA)专利数据。为构造2014-2025年职业暴露度所需的十年滞后窗口,首先保留申请年份2004-2024年、专利类型为“发明申请”或“发明授权”且摘要非空的记录,筛选后约有2593.5万条记录。在此基础上,根据人工智能关键词及高精度组合规则识别出345731条人工智能相关专利记录。年份t的职业人工智能暴露度仅使用t-10年至t-1年的专利信息,不纳入当年及未来专利,以避免前视偏误。因此,2014年指标使用2004-2013年的专利,2025年指标使用2015-2024年的专利,构造全部指标所需的申请年份总体范围为2004-2024年。
④上市公司岗位数据来自国内主流网络招聘平台,通过大数据抓取技术采集上市企业发布的招聘岗位信息,获取岗位名称、岗位职责及任职要求等信息,并据此识别企业不同职业及工作任务的招聘需求,完整数据覆盖2014年至2025年,共899.6万余条上市公司招聘记录。完成字段规范、有效证券代码筛选、岗位名称清洗和重复招聘识别后,形成约664.1万条测算记录。
二、人工智能暴露度测算流程
①构建人工智能术语和职业任务库。 首先整理人工智能相关术语,并统一英文术语、中文译名和常见缩写,形成用于人工智能专利识别的关键词表。随后依据《中华人民共和国职业分类大典(2022年版)》,提取职业名称、职业定义和主要工作任务,并将工作任务进一步拆分为“动词—名词”组合,例如“分析—数据”“开发—算法”等,从而建立标准化的职业任务库。
②识别人工智能专利并提取人工智能任务。 在专利标题和摘要中检索人工智能术语关键词,识别人工智能相关发明专利申请和发明授权。为降低通用词可能造成的误识别,根据预设规则对关键词进行筛选。随后从人工智能专利摘要中提取“动词—名词”任务对,并按照专利申请年份统计各任务对的出现频次,从而获得人工智能技术所涉及的任务结构。
③计算职业人工智能暴露度。 对于年份 (t),使用 (t-10) 至 (t-1) 年的人工智能专利数据计算职业人工智能暴露度,即利用过去十年人工智能技术所涉及的任务信息衡量当年职业受到人工智能技术影响的程度,从而避免使用当年及未来信息。具体而言,首先计算各“动词—名词”任务对在人工智能专利任务中的相对频率,然后将其与职业任务库进行匹配。对于同一职业,将其包含的任务对对应的人工智能相对频率分别计算均值和中位数,得到职业层面的人工智能暴露度。最后在年度内进行Min-Max标准化,使不同职业之间具有可比性。
④清洗和标准化企业招聘数据。 对网络招聘数据中的企业名称、证券代码、招聘年份、招聘日期、岗位名称和招聘人数等信息进行统一处理,并对无法确定具体招聘人数的“若干”“不限”等情况按照1人处理。为减少同一岗位重复发布对结果的影响,在企业、年份、月份和标准化岗位名称层面进行去重,从而获得企业年度岗位招聘数据。
⑤实现招聘岗位与标准职业的匹配。 岗位匹配采用“高置信度文本匹配+微调语义模型”的两阶段方法。第一阶段利用基于Levenshtein编辑距离的WRatio相似度,将名称高度相似的招聘岗位匹配到职业分类大典中的标准职业,并以这些高置信度结果构造模型训练样本。第二阶段以中文预训练模型BAAI/bge-small-zh-v1.5为基础,采用Multiple Negatives Ranking Loss对Sentence-Transformer进行微调,再依据岗位与标准职业向量之间的余弦相似度匹配其余岗位。模型验证集Top-1职业一致率为88.25%,两阶段最终覆盖约162万个不重复的标准化招聘岗位名称。
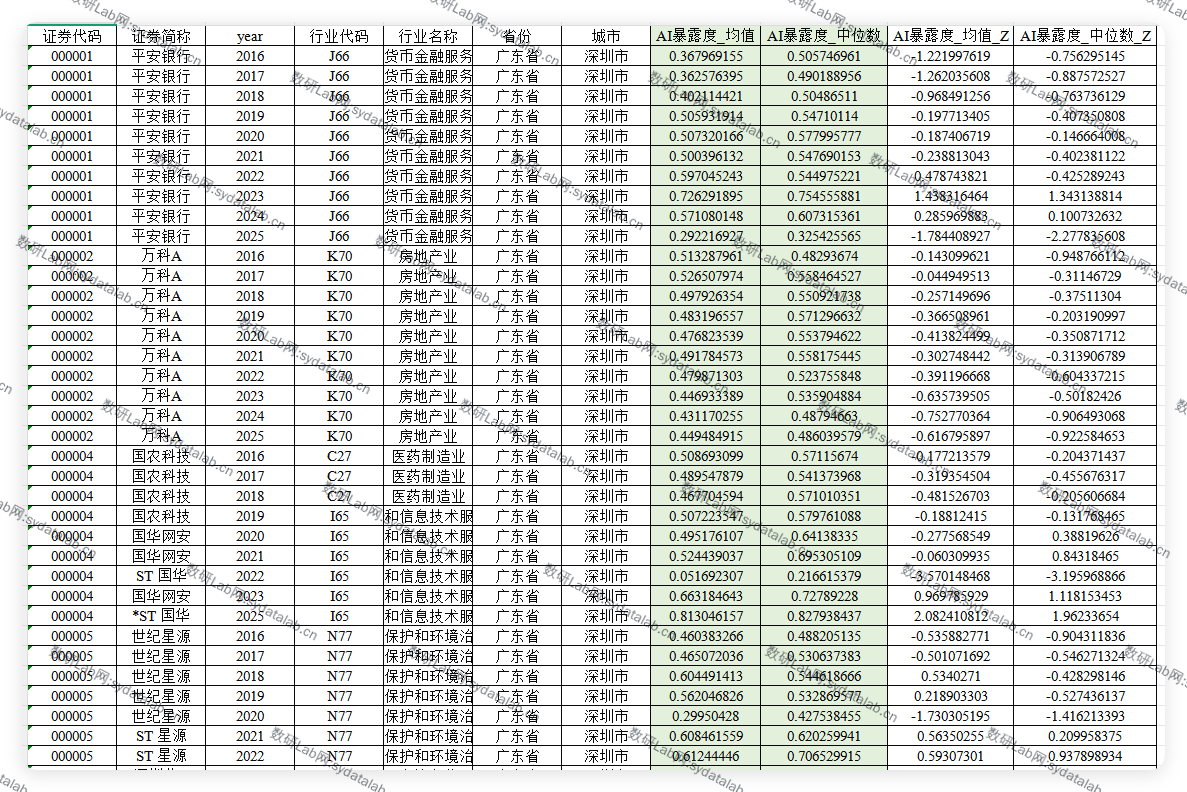
⑥汇总企业年度人工智能暴露度。将各招聘岗位所匹配职业在相应年份的暴露度赋予岗位,并以招聘人数衡量岗位在企业劳动力需求中的相对重要性。为减少个别超大招聘计划的影响,先在每个年份内对单条招聘记录的招聘人数进行99%分位数上端缩尾,再以缩尾后的招聘人数作为权重。企业年度人工智能暴露度等于该企业当年各岗位职业暴露度与招聘权重乘积之和,再除以有效招聘权重之和。上述计算分别使用职业暴露度均值版本和中位数版本,形成“AI暴露度_均值”和“AI暴露度_中位数”两个指标。
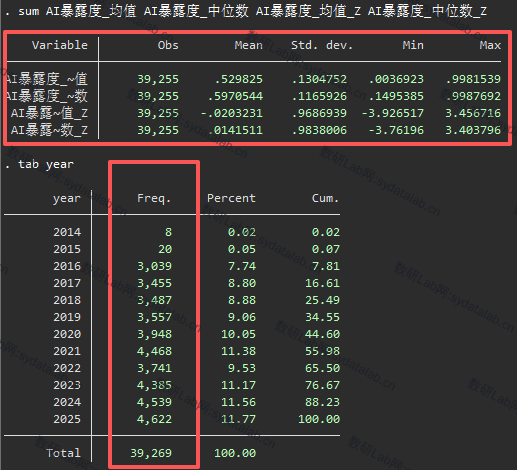
⑦匹配上市公司基本信息。企业年度指标按照证券代码和年份与上市公司证券简称、行业及地区信息进行严格匹配,不使用相邻年份信息进行替代,以保持年度口径一致。最终形成39269条上市公司-年份观测,覆盖5319家上市公司。另对全部可测算的企业—年度指标进行z-score标准化,作为备用变量保留在数据中。
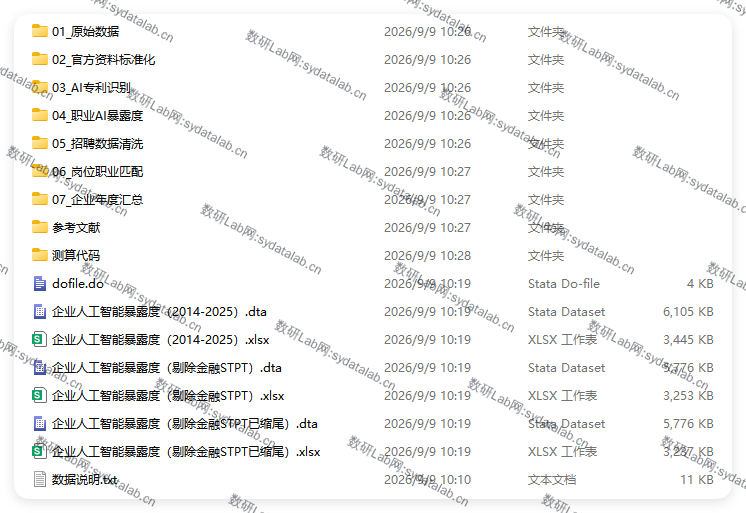
本数据分别提供完整样本、剔除金融/ST/PT样本、剔除后1%和99%双侧缩尾样本三种版本。完整样本共39269条公司—年份观测,覆盖5319家上市公司,剔除金融、ST和PT公司后,保留37147条公司-年份观测,覆盖5204家上市公司。
数据示例
参考文献
[1]刘行,张昊天,田轩.人工智能、人力资本结构与灵活用工——来自在线招聘大数据的经验证据[J].经济研究,2025,60(7):240-260..