上市公司-特质信息含量(2006-2025)
数据简介
本数据参考李四海、李震(2023)《企业社会责任报告特质信息含量的信号效应研究——基于自然语言处理技术的分析》(《中国工业经济》第1期),从企业社会责任报告中提取数量、时间、组织、人物和地点信息,衡量具体信息在全文中的相对密度。
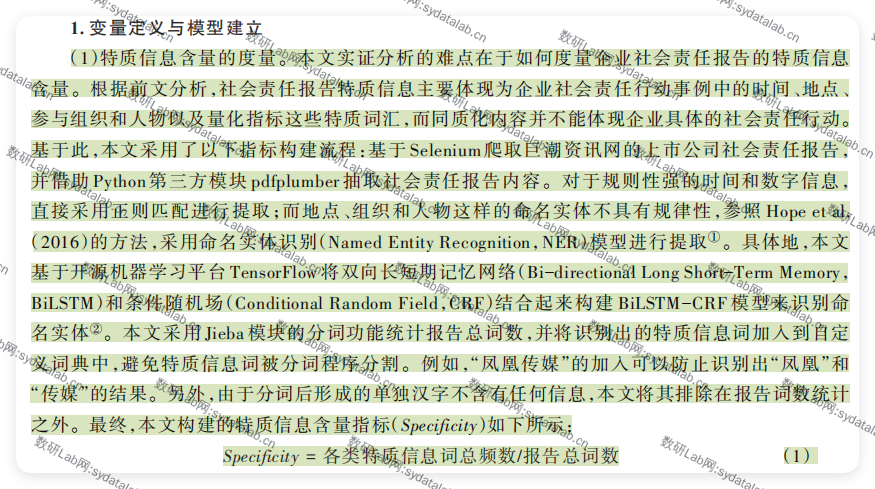
具体指五类特质信息词是指:数量词包括数字、金额、百分比及带单位的数量表达,如“10万元”“100人”“20%”;时间类包括年份、日期、季度和半年,如“2025年”“第一季度”;组织机构类包括具有明确指向的企业、学校和其他机构名称,如“比亚迪”“西南交通大学”;人物类指具体人名;世界地区类指国家、城市等地点名称。这些词从报告全文中识别,时间和数量通过正则规则提取,组织、人名和地点则由BiLSTM-CRF命名实体识别模型结合上下文判断。
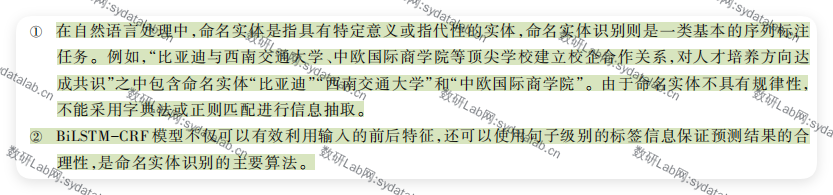
测算前,统一文本编码及全角英数字等字符,清理空字符和多余空白,合并中文换行。识别时,过滤“本公司”“集团”等缺少具体指向的泛称,以及单汉字、跨强标点的异常实体;遇到重叠表达,按时间、命名实体、数量的顺序保留,同一位置只计一次。总词频采用jieba精准模式统计,将识别出的特质信息词在原位置作为完整词保留,避免机构名称被拆开,其余文本正常分词,并剔除标点、空白和孤立单汉字。
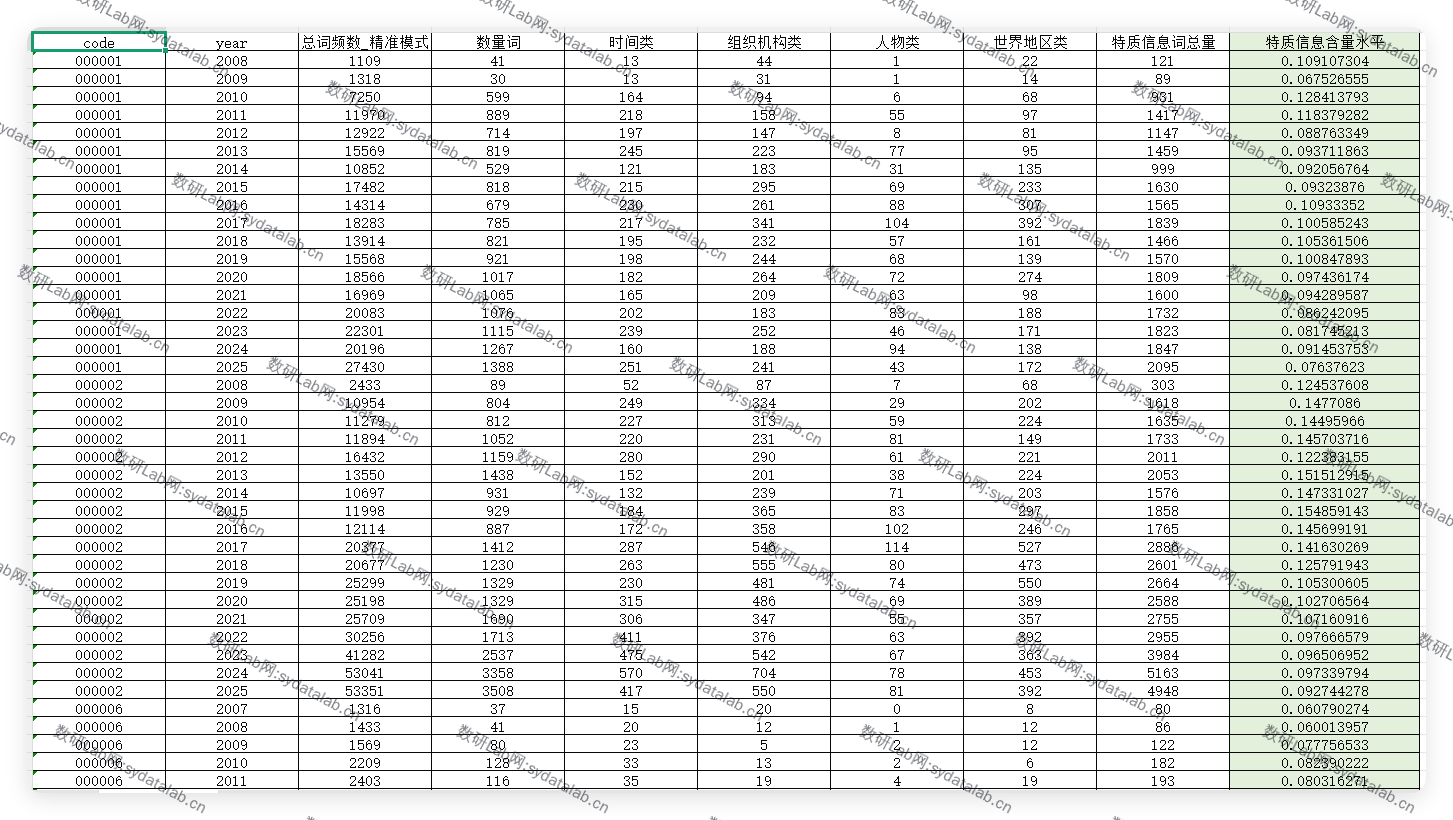
特质信息含量水平=(数量词+时间类+组织机构类+人物类+世界地区类)/总词频数,结果为比例,未乘100。数值越大,说明报告中这五类具体信息越密集。最终有效观测值19702条。
数据示例