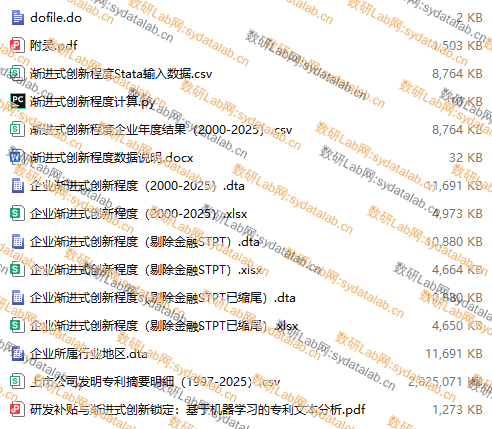
上市公司渐进式创新程度(2000—2025)| 基于专利文本TF-IDF向量与余弦相似度测算
数据简介
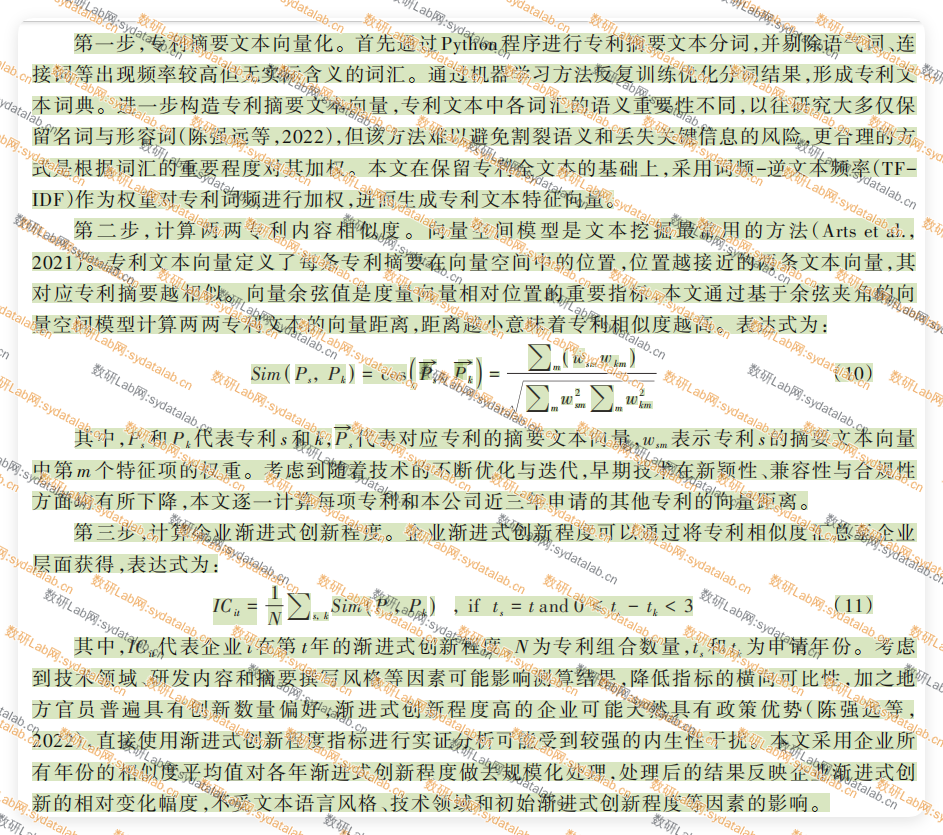
本数据参考孙雅慧、时省、彭飞和吴华清(2024)《研发补贴与渐进式创新锁定:基于机器学习的专利文本分析》的测度思路,利用上市公司发明专利文本识别企业创新活动对既有技术知识的延续程度。渐进式创新强调在原有技术范式、产品结构和工艺路线基础上的持续改良,其关键特征不是专利数量多寡,而是当期创新成果与企业已有知识基础之间具有较强的内容连续性。因此,本数据以企业当年新申请发明专利与同一企业近三年其他发明专利的文本相似度衡量渐进式创新程度,最终企业年度结果覆盖2000—2025年,数据处理时按照“证券代码—申请号”识别并去重专利,将专利名称与摘要合并为分析文本,经过文本规范化、中文分词以及停用词、数字和专利通用表述剔除后,采用词频—逆文本频率方法计算词项权重,形成经过L2标准化的专利级TF-IDF特征向量。
具体测算分为专利层面和企业年度层面。对企业i在t年申请的每一项发明专利Ps,将其与本公司t年、t−1年和t−2年申请的其他发明专利Pk逐一配对,并剔除专利与自身的重复比较。两项专利的内容相似度采用文本向量夹角余弦值计算:Sim(Ps,Pk)=Σm(wsm×wkm)/√[Σm(wsm²)×Σm(wkm²)],其中wsm和wkm分别表示专利s和专利k在第m个词项上的TF-IDF权重。余弦相似度越高,表明两项专利使用的技术词汇及其权重结构越接近。随后对企业当年全部有效专利比较对的相似度取算术平均,得到未标准化指标IC_raw:IC_rawit=(1/Nit)Σs,k Sim(Ps,Pk),条件为ts=t且0≤ts−tk<3,其中Nit为有效专利比较对数量。当企业当年没有发明专利,或近三年内不存在可比较的其他专利时,IC_raw记为0。
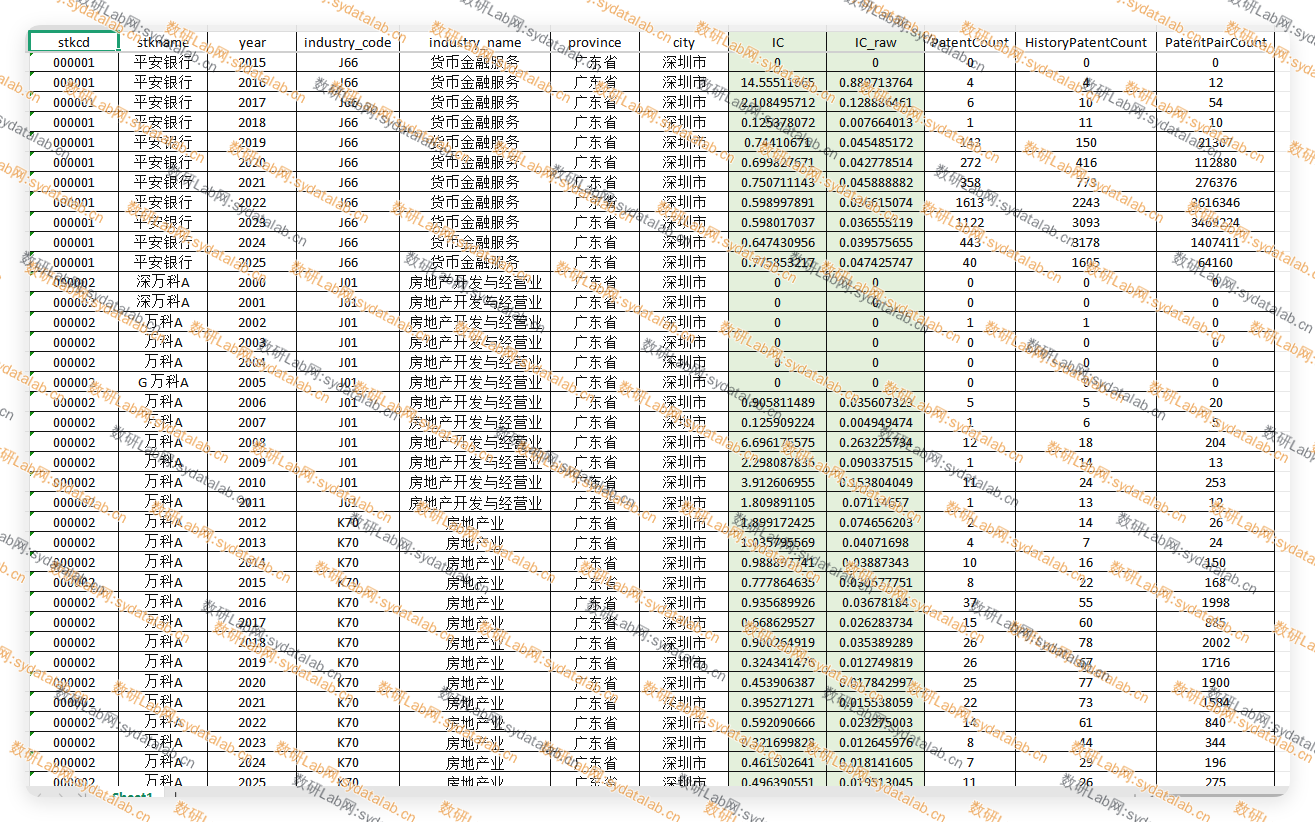
按照论文的去规模化思路,以企业全部样本年份IC_raw的平均值为基准进行标准化,构造核心变量IC,IC大于1表示企业当年的渐进式创新程度高于自身样本期平均水平;数值越高,说明当期创新越多地沿用和改进既有知识路径,技术连续性及路径依赖越强。结果同时保留PatentCount(当年发明专利数量)、HistoryPatentCount(近三年候选专利数量)和PatentPairCount(有效专利比较对数量),最终数据包含74304个企业年度观测、5850家上市公司,并提供全样本、剔除金融业与ST/PT、剔除金融业与ST/PT后对连续变量进行1%和99%缩尾三版Stata及Excel结果。2025年专利申请可能受公开滞后影响,开展年度比较或实证分析时应注意右截尾风险。
数据示例