人工智能技术风险暴露(2015-2025)
数据简介
特别注明!!!本数据测算的人工智能技术风险暴露度与传统意义上的人工智能暴露度存在明显区别。人工智能暴露度通常从职业任务或技术应用角度出发,衡量企业岗位工作内容受到人工智能技术影响的程度,侧重反映人工智能技术对企业劳动力需求及工作任务的潜在影响。而本数据关注的是企业在人工智能技术研发、引入、应用及商业化过程中面临的风险与不确定性,重点识别企业年报中披露的技术可靠性、数据安全、法律合规、应用实施、成本收益及外部依赖等风险,以及企业采取的相关防范措施。因此,两类指标在研究对象、数据来源和测算方法上均有所不同,不能相互替代。需要传统人工智能暴露度、AI暴露度数据可参考: https://www.sydatalab.cn/content/b4f7772f-5173-4ae4-b53e-137fea10da15/
本数据基于上市公司年度报告中的管理层讨论与分析(MD&A)、重要提示及重大风险提示等章节,结合企业经营活动描述与风险披露内容,采用关键词筛选、大语言模型辅助标注与FinBERT微调分类相结合的方法,识别企业在人工智能技术研发、应用及商业化过程中面临的风险与相关防范措施,并在企业年度层面构建人工智能技术风险暴露指标。之所以纳入年报中的“重要提示、目录、释义及重大风险提示”等前置章节,主要是参考金星晔等(2024)发表于《经济研究》的《企业数字化转型的测度难题:基于大语言模型的新方法与新发现》的年报文本处理思路,在管理层讨论与分析(MD&A)之外补充相关章节,以扩大企业技术活动及风险信息的识别范围。具体测算过程如下。
第一,基于关键词检索与邻句扩展构建候选文本。 首先建立包含241个关键词的检索词典,覆盖人工智能技术及应用表达、风险触发词、人工智能专有风险短语和风险防范治理词等类别。将命中有效关键词或补充表达的句子纳入候选集合,并对命中人工智能相关锚定词的句子进行同段落前后句扩展,以保留通过指代、承接等方式描述的企业活动、潜在风险及防范措施。文本预处理统一规范字符形式、英文大小写及词语边界,同时对GAN等具有歧义的技术缩写设置语义限制,减少非人工智能内容的误识别。经过筛选,共获得51万+个候选句。需要说明的是,关键词检索仅用于缩小后续模型识别范围,关键词命中并不直接代表企业存在人工智能活动或披露相关风险。
第二,结合DeepSeek辅助标注与FinBERT微调模型开展文本识别。 从候选句中抽取约10%的样本,利用DeepSeek大语言模型按照统一标注规则进行分类,分别判断目标句是否涉及本企业人工智能活动、是否披露人工智能相关风险以及是否披露相应防范措施,并将标注结果作为弱监督训练数据,对FinBERT预训练模型进行微调。在具体识别过程中,采用两阶段分类方法:第一阶段判断目标句是否涉及企业自身的人工智能研发、采购、引入、应用、运营、产品服务或商业化等活动,包括明确计划开展的相关项目,以及使用第三方人工智能产品或服务的情形;仅涉及行业趋势、宏观政策或其他企业活动,且无法明确关联本企业的表述予以排除。第二阶段针对识别出的企业人工智能活动相关句子,分别计算风险披露与风险防范的分类概率,并依据各自分类阈值独立判断,允许同一句同时包含风险与防范信息。其中,风险披露主要涵盖人工智能研发和应用过程中的技术可靠性、模型系统、数据安全、法律合规、成本收益、应用实施及外部技术依赖等不利影响或不确定性,不要求相关风险已经造成实际损失;风险防范则包括针对上述风险采取的预防、控制、治理、缓解、修复及保障措施。仅利用人工智能识别或管理信贷、供应链等一般经营风险的表述,不直接认定为人工智能技术风险,一般性的技术升级和效率提升也不自动认定为风险防范。模型输入以目标句为识别对象,同时引入同段前后句及公司信息作为辅助上下文,以提高对企业活动主体、语义指代和风险内容的识别能力。完成模型微调后,将其应用于候选句集合,形成企业人工智能风险与风险防范的句子级识别结果。
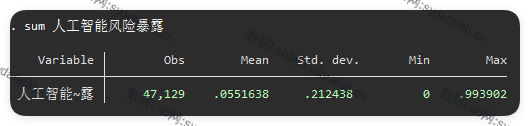
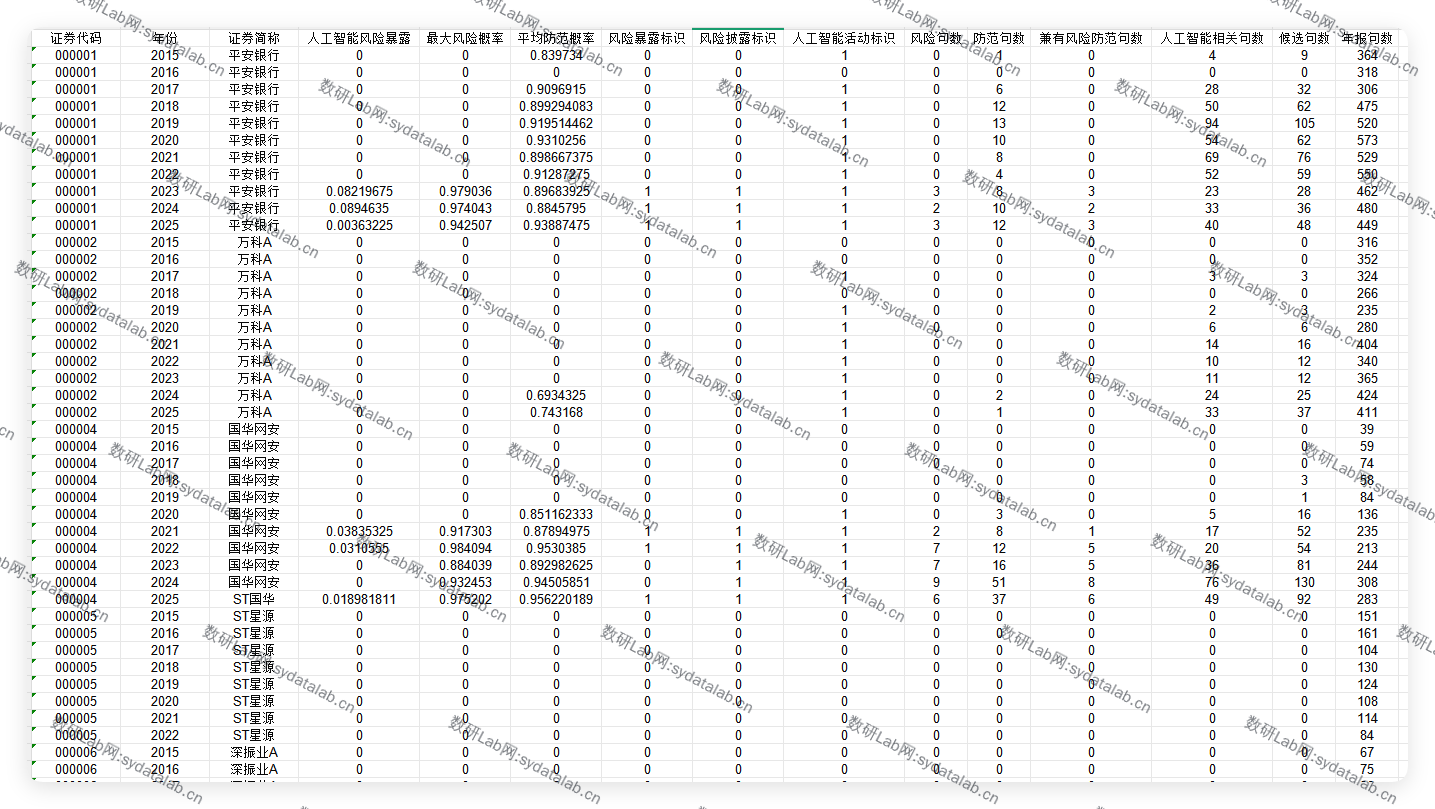
第三,基于风险与防范分类概率构建企业年度风险暴露指标。 参考陆瑶等(2025)《中国企业数字技术风险暴露对企业价值的影响——来自大语言模型的文本分析证据》的概率差值方法,将企业人工智能技术风险暴露定义为:人工智能风险暴露=max(最大风险概率-平均防范概率,0)。其中,最大风险概率为企业当年所有被识别为人工智能风险句的风险分类概率最大值,用于反映年度报告中最强的风险披露信号;平均防范概率为企业当年所有被识别为风险防范句的防范分类概率算术平均值,用于衡量相关防范措施的文本披露信号。同一句同时涉及风险与防范时,分别纳入对应集合计算。对于未识别出风险句或防范句的企业年度,相应概率赋值为0;两项概率相减后若结果为负,则将风险暴露指标设为0。对于具有有效年报正文但未筛选出候选句的企业年度,风险暴露指标同样记为0;缺乏有效年报正文的企业年度则保留为缺失值。该指标通过风险与防范的分类概率差异刻画企业人工智能技术风险暴露程度,不采用风险句数占年报总句数或候选句数的比例进行测算。
第四,形成企业年度人工智能技术风险暴露数据。 根据上述识别与汇总方法,最终共有4864个企业年度被识别出人工智能相关风险披露。相较于单纯依靠关键词频次或风险句数量的测算方式,本数据结合企业实际人工智能活动、风险披露内容及相应防范措施,利用FinBERT微调模型提取句子层面的分类概率,并进一步构建企业年度风险暴露指标,以更有针对性地刻画上市公司人工智能技术活动中披露的风险及其防范情况。
数据示例